让 SO-100 学会把物体放进抽屉:从 MuJoCo、MimicGen 到 ACT 数据飞轮
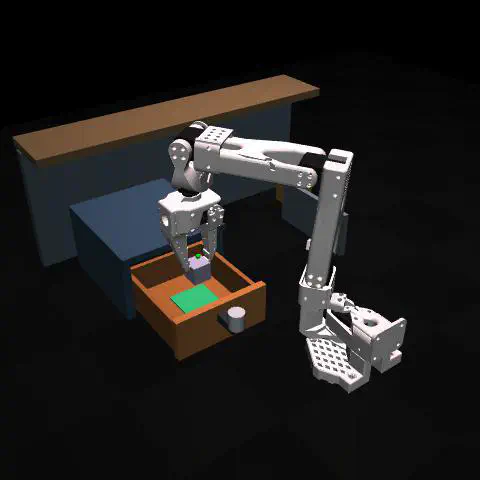 MuJoCo 中的 SO-100 抽屉任务,画面来自 ACT 自主执行。
一个机器人能把物体抓起来,不代表它能完成“打开抽屉、把物体放进去、再关上抽屉”。这个任务要连续处理把手接触、抓取、狭窄空间中的搬运、松爪和撤离。前一步留下的几毫米误差,可能在后一步变成碰撞或掉落。
这个项目以 SO-100 机械臂为对象,在 MuJoCo 中实现了上述完整任务,并把它做成一条可以追踪的数据闭环:生成示教 → 清洗标注 → 质量检查 → 冻结数据集 → 训练 ACT → 自主评估 → 根据失败补采。
先给出结果:初始 100 条合格示教训练出一个 ACT;分析失败后,再补采 100 条脚本示教,进行一次继续训练。统一替换模型曾造成退步,最终采用“方块用新 ACT,盒子和杯子用旧 ACT”的固定选择规则。在另外冻结的 60 个新场景中,完整任务成功率从 39/60(65.0%)提高到 44/60(73.3%)。这是一套有收益、也有明确失败边界的仿真原型。
本文讨论的是这条抽屉单任务实验线。数据来自仿真脚本及其轨迹扩增,人工示教为 0;ACT 输入为关节和仿真环境状态,视频用于观察,当前没有训练视觉策略,也没有进行真机验证。
1. 任务怎么定义,仿真怎么搭
从“看起来放进去了”到可计算的成功条件
每个 episode,也就是一次完整尝试,只操作一个物体,从方块、长方体盒子、空心杯子三种 SKU 中选择。机械臂需要依次完成:
- 夹住把手,把抽屉拉开超过 9 cm。
- 抓起物体,物体中心高度超过 5.5 cm。
- 把物体完整放进抽屉内部并松爪。
- 将抽屉关闭到开度小于 8 mm,松开把手并撤离。
- 物体、抽屉稳定至少 15 个控制步,即 0.75 s。
“完整放入”会考虑物体朝向和外接尺寸,不能只检查物体中心是否落在抽屉投影内。放入事件还要求抽屉此前确实打开、当前开度大于 7.5 cm、物体此前被抬起且夹爪已经张开。最终稳定条件要求抽屉速度小于 0.015 m/s、物体平移速度小于 0.03 m/s,末端离把手超过 5.5 cm。每次自主评估运行 1,200 个控制步,最多观察 60 s。
这样定义任务,才能区分“物体在抽屉上方”“物体已放入但没关抽屉”和“全部完成”。否则,漂亮的视频截图很容易掩盖未完成的步骤。
机械臂、抽屉和物体各自如何运动
基础模型来自 MuJoCo Menagerie 的 trs_so_arm100,使用 MuJoCo 3.3.7。这里的机器人是 5 个机械臂关节加 1 个夹爪关节,不是可以任意实现六维末端位姿的六轴机械臂。
仿真步长是 0.002 s,即物理引擎以 500 Hz 积分;控制频率为 20 Hz,每条指令推进 25 个物理子步。动作是 6 维的绝对关节位置目标,单位为弧度。程序将目标限制在执行器范围内后写入 data.ctrl,位置伺服器再驱动关节运动。动作本身不是力矩,也不是末端坐标增量。
抽屉有一个被动滑动关节,没有单独的驱动电机。机械臂通过夹爪与把手接触来拉开、推回抽屉。物体有自由关节,其运动由接触、摩擦和重力决定;没有用焊接约束把物体粘到夹爪上。空心杯子由底部和 12 个杯壁碰撞几何体组成,夹爪可能碰到杯壁或杯口,因此其接触行为与实心方块不同。机械臂连杆使用重力补偿,物体仍受重力作用,这也是当前仿真的建模选择。
随机什么,固定什么
本轮先固定接触条件,把主要变化放在物体初始位置和 SKU 上,避免同时改变任务、动力学与视觉后难以定位失败。
| 项目 | 当前实验设置 |
|---|---|
| 物体位置 | x 均匀采样于 −77~−53 mm,y 均匀采样于 −247~−223 mm |
| 物体实例 | 方块、盒子、空心杯子,每种尺寸固定,初始 yaw 为 0 |
| 抽屉与目标 | 初始关闭,放置目标固定在抽屉内部,随抽屉移动 |
| 物体质量 | 15 g |
| 滑动摩擦系数 | 物体 2、支撑面 1、把手 3 |
| 接触与阻尼 | 接触时间常数 0.004 s,抽屉关节阻尼参数 1 |
| 时序扰动 | 不注入命令延迟和随机丢包 |
这里的随机位置范围只有 24 mm × 24 mm,结果不能外推到整张桌面。少量关节测量噪声,以及光照、颜色、相机扰动仍保留;由于 ACT 不看图像,画面变化不构成视觉鲁棒性的验证。观察相机调整到能同时看到物体、夹爪和抽屉内部的位置,腕相机也修正为朝向作业区,方便判断接触与落点。
2. 第一批示教从哪里来:脚本、FK 与 IK
模仿学习需要先有成功动作。项目先用脚本写出任务阶段:接近把手、夹紧、拉开、离开把手、接近物体、闭爪、抬升、搬运、放入、松爪、关抽屉、撤离。阶段标签由脚本提供,后续再结合物理事件核验。
脚本指定的是末端目标位置、姿态和夹爪开度,而机器人接受关节目标。两者通过运动学连接:
- 正向运动学(FK):给定关节角,计算末端位置和方向。实现中把关节角写入独立的
MjData,调用mj_forward,读取末端 site 的位置和四元数。 - 逆向运动学(IK):给定末端目标,迭代寻找满足关节限位的关节角。
IK 使用阻尼最小二乘。令末端误差为 $e$,雅可比矩阵为 $J$,一次更新为:
$$ \Delta q = J^\mathsf{T}(JJ^\mathsf{T}+\lambda I)^{-1}e, \qquad \lambda=10^{-5}. $$雅可比描述“关节微小变化会让末端怎样移动”;阻尼项用来缓解接近奇异位形时更新过大的问题。实际求解只调整前 5 个机械臂关节,姿态误差及对应雅可比权重为 0.15,单次迭代关节增量限制在 ±0.12 rad,并保留关节限位余量。阶段之间使用平滑插值,减少关节目标突变。
五个机械臂自由度通常无法同时精确满足任意三维位置与三维方向,因此 IK 返回一个解,不等于末端完全到达目标,更不等于抓取成功。项目记录 IK 残差,并让每条示教在物理引擎中实际执行。物体是否真的抬起、是否掉落,都由仿真结果判断。
这一步最终得到 13 条成功的脚本源演示。它们负责提供可迁移的动作结构,接下来再扩增到 100 条。
3. MimicGen:按参考物拆解并迁移轨迹
如果物体的位置移动 1 cm,机械臂不应该原封不动地重放旧关节角;但也不必从头设计整条轨迹。MimicGen 的关键思路是:把一段动作表达在它所操作的参考物坐标系中,再迁移到新场景。
为什么要拆成四段
开抽屉时,动作相对于把手有意义;抓取时,动作相对于物体有意义;放入时,应相对于抽屉内的目标。若对整条轨迹施加同一个平移,物体移动后,把手接近动作也会被错误地平移。
| 子任务段 | 源轨迹索引,左闭右开 | 参考物 |
|---|---|---|
| 开抽屉、离开把手 | [0, 255) | 把手 |
| 接近、抓取、抬起 | [255, 430) | 物体 |
| 搬运、插入、松爪、退开 | [430, 645) | 抽屉内目标 |
| 关抽屉、松爪、撤离 | [645, 920) | 把手 |
这些边界来自源轨迹已有的阶段标签。这里没有使用无监督算法自动发现子任务。对每个新场景,先在同 SKU、同训练或验证集合内,选择初始物体位置最近的源演示。
位姿变换具体做了什么
用 $T$ 表示 4×4 齐次变换矩阵,其中包含旋转与平移。假设源场景参考物和末端在世界坐标系中的位姿分别为 $T_{\mathrm{src,ref}}$、$T_{\mathrm{src,ee}}$,先求末端相对于参考物的位姿:
$$ T_{\mathrm{ref,ee}} =T_{\mathrm{src,ref}}^{-1}T_{\mathrm{src,ee}}. $$新场景中,把相同的相对关系放回世界坐标系:
$$ T_{\mathrm{new,ee}} =T_{\mathrm{new,ref}} T_{\mathrm{src,ref}}^{-1} T_{\mathrm{src,ee}}. $$直观地说,就是保留“从物体上方多高、哪一侧接近”的关系。当前参考坐标系采用平移加单位旋转,物体初始朝向固定;公式支持一般刚体变换,但本实验没有验证任意旋转迁移。
这里有一个实现细节:源末端目标由记录的关节动作做 FK得到,不把含噪关节观测直接当成控制目标。迁移后保留源夹爪指令,以源关节角作为 IK 初值求解新的机械臂目标;三处段间边界各插入 10 个插值动作,最终每次生成执行 950 个动作。物理仿真仍然决定实际末端与物体如何运动。
项目调用了上游 MimicGen 的 transform_source_data_segment_using_object_pose、WaypointSequence.from_poses 和 WaypointTrajectory.merge,外层由自定义 SO-100 适配器负责环境与控制接口。因此这是使用官方位姿及路径组件的适配实现,并非直接运行完整的 robosuite DataGenerator 工作流。
扩增后为什么还要重新执行和质检
几何相对关系保持了,接触结果却未必保持。迁移可能让机械臂接近限位,也可能改变夹爪碰到物体的位置。尤其是杯口和狭窄抽屉附近,几毫米差异就足以让夹取失败。
实际尝试 128 次,100 条通过、28 条隔离;隔离中 27 条未抓起,1 条搬运或放入失败。合格集包含方块 34、盒子 33、杯子 33,共 94,857 个对齐后的时间步,划分为 80 条训练、20 条验证。因此,“100 条成功演示”是质量筛选后的规模,生成器通过率约为 78.1%。
只保留成功轨迹也会使数据偏向容易完成的位置。后续评估必须从预先冻结的位置分布取样,不能只在成功采集过的位置重放。
4. 把轨迹变成可以训练、可以追溯的数据
数据飞轮的中间部分经常被一个 dataset 目录带过,但时间错位、错误标签或同源泄漏,都会直接影响模型结论。项目把原始记录、清洗结果和数据版本分开保存。
原始记录与时间对齐
原始文件采用自定义 HDF5 schema warehouse.raw.v2,包含关节、动作、环境状态、末端位姿、夹爪、RGB-D、腕相机,以及仿真接触力和触觉代理。后两者来自 MuJoCo 接触计算,不是硬件传感器测量。每一路记录设备时间、主机时间、序号、单位及标定信息。
虽然这些流都来自仿真,采集层仍模拟设备时钟的偏移、漂移和少量抖动,用同步锚点拟合:
$$ t_{\mathrm{ref}} = a\,t_{\mathrm{device}} + b. $$其中 $a$ 修正时钟速率,$b$ 修正起点。它验证的是同步软件协议,并不能证明真实相机和电机已经硬件同步。
清洗后统一到 20 Hz 网格:关节角做线性插值;末端平移做线性插值,四元数做 SLERP;动作、环境、接触和图像取该时刻之前最近的有效样本。动作尤其不能从未来插值,否则会把下一步命令提前配给当前观测。
图像原始采样为 10 Hz,对齐到 20 Hz 不会凭空增加图像信息,相邻时间步可能复用同一帧。每个流保留有效性掩码和样本年龄,通过序号缺口与时间间隔检测丢帧,并保存相机内外参、以米为单位的深度。当前训练只加载所需的状态与动作数组,避免把未参与训练的全部图像占进内存。
标注、门禁和隔离
阶段由脚本或源轨迹标签给出,任务事件由仿真状态自动判断,标注中明确 human_reviewed=false。质量检查覆盖完整成功、危险碰撞、奇异位形、关节限位、时间单调性、缺失值、标定一致性和动作连续性。
例如,动作速度超过 12 rad/s、加速度超过 150 rad/s²,或专家 IK 最大位置残差超过 2 cm,都会触发拒绝;FK 与记录末端位置的误差第 95 百分位超过 8 mm,也会触发检查。危险碰撞针对非允许接触中超过 2 mm 的穿透,允许正常的夹爪、物体与抽屉接触。因此文中的“零危险碰撞”指该仿真指标。
失败 episode 保留原始文件与拒绝原因,进入隔离区;不会删掉失败片段,再拼成一条貌似成功的长轨迹。只有合格记录进入训练版本。
版本和划分为什么比文件名更重要
SQLite 资产库保存任务、SKU、场景 seed、来源和质量状态;原始文件、清洗文件、标注及模型保存 SHA-256。冻结 manifest 固定本轮使用的文件集合,训练记录再关联 manifest 哈希,从模型可以追溯到具体数据版本。
划分以 episode 为单位,不能把相邻帧随机分给训练集和验证集。MimicGen 还要更进一步:先隔离源演示家族,再生成扩增轨迹。13 条源演示中,10 条只用于训练生成,3 条只用于验证生成,源哈希不交叉。否则,同一条动作仅平移几毫米后出现在验证集,会高估泛化能力。
平台已有 NPZ、Parquet、LeRobot v3 和 RLDS 导出器。本轮 ACT 直接读取冻结版本的 NPZ;原始 HDF5 是项目采集格式,不能称为 LeRobot 标准数据集,也没有为当前 200 条数据重复生成全部格式。Ego、UMI/FastUMI 等接口在平台中属于合成协议适配验证,当前实验数据都来自同一仿真本体。
5. ACT 实际学到了什么
输入、输出与模仿学习目标
这里使用 LeRobot 0.4 的官方 ACTPolicy。ACT 全称 Action Chunking Transformer,本质上是行为克隆:从演示中学习“当前观测下,接下来应执行怎样的一段动作”。本轮没有用奖励函数做强化学习更新。
每个训练样本先随机选一条 episode,再选择起点 $t$,输入当前状态,监督信号为未来 50 步专家动作。超出 episode 末尾的部分补齐,并用 padding mask 屏蔽其误差。
| 模型字段 | 维度与含义 |
|---|---|
observation.state | 6 维:5 个机械臂关节和 1 个夹爪关节 |
observation.environment_state | 18 维:物体位置 3、目标位置 3、抽屉开度与速度 2、已打开与已放入标志 2、物体半尺寸 3、yaw 的 sin/cos 2、任务标志 3 |
action | 50×6:未来 50 步绝对关节位置目标 |
任务标志在本轮始终表示抽屉任务 [0, 0, 1],用于复用平台接口,并不意味着同时训练推移和桌面抓放。脚本阶段编号不作为策略输入;但“已打开”“已放入”等事件标志来自仿真历史状态。
物体位置、目标位置和事件真值在真实机器人上需要感知与状态估计才能获得。本实验直接使用这些信息,属于特权状态策略。相机画面没有进入网络,不能从视频效果推断机器人已经学会视觉识别。
为什么一次预测一段动作
逐步行为克隆每次只预测一个动作,容易产生抖动,并在偏离示教轨迹后积累误差。ACT 同时预测一段相互关联的动作,使“接近—闭爪—抬升”这样的局部运动更连贯。
本项目预测 50 步,即 2.5 s;实际执行前 25 步,即 1.25 s,再读取新观测重新预测。这是分块重规划,块内仍是开环执行,当前没有启用 temporal ensembling(对重叠预测进行时间集成)。因此它不会每 50 ms 都根据物体位置重新规划,接触突然变化时仍可能反应不足。
推理过程可以概括为:
policy.reset()
while not rollout_finished:
    q, env = observe()
    chunk = predict(normalize(q), normalize(env), latent=zeros(16))
    for action in denormalize(chunk[:25]):
        simulator.step(action)  # 每步 0.05 秒
实际代码通过 select_action() 的动作队列实现这一逻辑。IK 和脚本专家只负责生成演示;ACT 自主评估时直接输出关节目标。
Transformer 和 CVAE 分别负责什么
Transformer 将关节状态、环境状态和潜变量分别投影到 128 维 token。编码器融合它们,解码器通过 50 个时间位置的查询一次输出 50 个动作。当前使用 4 个注意力头、2 层编码器、1 层解码器,前馈层宽度为 512。
同一个观测可能对应多种合理动作风格,例如不同的接近速度。ACT 用条件变分自编码器(CVAE)表达演示中的这类变化。训练时,额外的 VAE 编码器读取当前关节状态与未来专家动作块,预测潜变量分布的均值和方差,再通过重参数化采样:
$$ z=\mu+\sigma\odot\epsilon, \qquad \epsilon\sim\mathcal N(0,I). $$动作预测器以当前观测和 $z$ 为条件重建专家动作。目标函数由动作 L1 误差与 KL 正则组成:
$$ \begin{aligned} \mathcal L &= \operatorname{mean}\!\left[m\odot|\hat A-A|\right] \\ &\quad +0.1\,D_{\mathrm{KL}}\!\left(q_\phi(z\mid q,A)\,\|\,\mathcal N(0,I)\right). \end{aligned} $$$m$ 是非 padding 掩码,$A$ 是专家动作块。这里的训练 L1 按上游实现,在掩码置零后对完整张量求平均。KL 项把潜变量分布拉近标准正态先验,约束潜变量对训练动作的记忆。潜变量维数为 16,VAE 编码器为 2 层。
推理时没有未来专家动作,VAE 编码器不参与,潜变量固定为零。 模型只根据当前观测生成动作块,这一点区分了训练监督信号与执行时可用信息。
训练设置与检查点选择
关节、环境和动作都用训练集的均值与标准差归一化,标准差下限为 0.01。验证数据不参与统计量计算;继续训练时沿用旧模型的归一化,保持已有权重的输入输出含义。
初始 100 条数据只启动一次训练:随机种子 42、20,000 steps、batch size 64;优化器为 AdamW,学习率从 2×10⁻⁴ 余弦下降到 1×10⁻⁵,权重衰减 10⁻⁴,梯度裁剪为 1。每 100 步抽取一个验证 batch,以验证动作 L1 保存最佳检查点。本次选中 step 14,800,归一化验证 L1 为 0.02651。
这个选择指标有两个局限:单个随机验证 batch 带来估计噪声;动作误差小也不保证完成接触任务。末端在夹取瞬间偏几毫米,平均动作误差可能仍很小,但物体已经抓空。因此最终判断必须靠完整自主 rollout。
6. 失败怎么推动下一轮采集
先区分“模型没学会”和“示教也做不到”
初始 ACT 在预先固定的 15 个未见场景上成功 7/15:方块 1/5、盒子 4/5、杯子 2/5,危险碰撞为 0。8 个失败里,5 个没有抬起物体,3 个抬起后没有放入。
接着在相同位置、相同物理条件下运行原脚本与 MimicGen,得到三类证据:
| 对照结果 | 失败数 | 下一步该修什么 |
|---|---|---|
| 脚本和 MimicGen 都成功,ACT 失败 | 3 | 策略执行误差,优先补有效示教覆盖 |
| 原脚本成功,MimicGen 和 ACT 失败 | 3 | 当前源选择或轨迹迁移不足,先获得可靠演示 |
| 原脚本和 MimicGen 都失败 | 2 | 接触控制本身困难,先修采集器 |
第三类尤其关键。若连示教器也抓不起来,盲目增加同类失败尝试不会得到有效的行为克隆监督。
杯子:平移和减速没用,抓取朝向起了作用
对两个困难杯子场景尝试抓取位置 ±2 mm 和接触阶段减速,问题仍未解决。在 cup 20302 场景中,原脚本下降结束时末端 TCP 高度约 62.2 mm,目标却是 32 mm,接触主要集中在单侧指尖。这提示实际接触阻碍了下降,不能只盯着规划目标看。
将杯子抓取的末端朝向旋转 30° 后,3 个已知杯子失败场景都由脚本完成,原朝向只能完成其中 1 个。修正后该场景 TCP 下降到约 32.6 mm,两指闭爪阶段最大接触力代理约为 48.5/47.1 N,抬升后物体中心高度约 68.2 mm。质量、摩擦和阻尼没有改变。
图中是脚本对照。接触力为仿真求解器输出,支持对接触姿态的诊断,但不能等同于真实硬件受力,更不能据此宣称 ACT 已学会修正后的杯子抓取。
定向补采,而不是重复容易的位置
补采新增方块 40、盒子 20、杯子 40 条合格演示。训练候选中,75% 从已知失败位置附近 ±3 mm 采样,25% 从原范围均匀采样;验证候选保持均匀采样。质检后实际接受的 100 条中,58 条来自失败邻域、42 条来自均匀分布。候选比例和最终入库比例不同,是成功筛选与划分共同作用的结果。
实际尝试 110 次,10 条方块失败进入隔离区。旧 100 条全部保留,合并后为 200 条、186,710 个时间步,160 条训练、40 条验证。新增数据直接执行修正脚本,来源标为 sim_scripted_recovery;它们没有被冒称为人类示教,也不是再次通过 MimicGen 扩增得到。
随后从原 ACT 权重继续训练一次,仍为 20,000 steps,随机种子 43,最佳检查点为 step 16,700,验证 L1 为 0.01316。本文这条实验线包括一次初始训练、一次补采后的继续训练;后面的选择器不需要额外训练。
7. 为什么不能直接把新模型替换上去
旧失败修好了,不代表新场景更好
补采后,旧 15 个场景的回归结果从 7/15 提高到 11/15。因为这些场景已用于失败分析与采样设计,这个结果只能说明已知问题有所改善。
在预先保留的另一组 30 个新场景上,直接使用更新后的统一模型却从 18/30 降到 14/30:
| SKU | 原 ACT | 更新 ACT |
|---|---|---|
| 方块 | 1/10 | 4/10 |
| 盒子 | 10/10 | 3/10 |
| 杯子 | 7/10 | 7/10 |
| 合计 | 18/30 | 14/30 |
方块有改善,盒子明显退化,杯子持平。新增数据偏向困难区域,且包含与旧轨迹不同的动作风格,这些都是可能原因;当前没有单因素消融,不能把退步唯一归因于“灾难性遗忘”或某一种数据偏移。验证集和数据组成也发生了变化,两轮 L1 的下降不能直接作为跨版本能力提升的证据。
这一轮飞轮的价值也体现在这里:它发现并阻止了一个总体退步的模型直接替换旧模型。
固定 SKU 选择,再用全新场景验证
根据上述 30 个场景,冻结一条简单规则:方块选更新 ACT,盒子和杯子选原 ACT。SKU 在 episode 重置时由场景提供,整条 episode 固定使用该模型。执行中不按成功与否切换,也没有脚本接管。
checkpoint_by_sku = {
    "cube": updated_act,
    "box": original_act,
    "cup": original_act,
}
active_policy = checkpoint_by_sku[sku]  # 仅在 reset 时选择
active_policy.reset()
这是一套两个检查点组成的固定选择方案。由于那 30 个场景已经参与选择规则设计,它们随即成为开发证据,不能继续当作最终独立测试。
于是另行冻结 60 个新场景,每种 SKU 20 个,锁定选择规则和检查点哈希后,分别执行旧 ACT 与新方案,共 120 条完整自主轨迹:
| SKU | 原 ACT | 固定 SKU 选择方案 |
|---|---|---|
| 方块 | 6/20 | 11/20 |
| 盒子 | 18/20 | 18/20 |
| 杯子 | 15/20 | 15/20 |
| 总计 | 39/60,65.0% | 44/60,73.3% |
同场景配对比较中,5 个场景由失败变成功、0 个由成功变失败;改善全部来自方块。盒子和杯子使用同一旧模型,前后动作与状态数组也逐项一致。120 条保存的动作序列全部重新物理执行,重放状态和最终成功判定一致。
下面是一组代表性改善案例,seed 为 52100。两个视频均为 ACT 自主执行,保持相同初始场景;原策略在搬运或放入阶段失败,固定选择方案完成任务。它展示的是 5 个改善案例之一,整体结论仍以全部 60 个场景为准。
评估汇总可下载:最终 60 场景统计。成功率提升为 8.3 个百分点,危险碰撞为 0,但仍有 16 个失败场景。配对精确双侧检验 p=0.0625,未达到常用的 0.05 显著性阈值;也没有额外训练步数相同的对照,不能把全部提升单独归因于新增数据。这个结果支持“本次独立样本中有所改善”,不支持“已经保证所有随机位置成功”。
8. 如何阅读实现与复现实验
实现可以沿着数据流阅读,而不必先理解所有平台代码。下列路径均相对于仿真项目根目录 every-embodied/1,与本文所在的博客仓库分开。
| 模块 | 建议关注的实现 |
|---|---|
so100_flywheel/sim.py | 模型加载、关节控制、FK、阻尼 IK |
so100_flywheel/drawer.py、domain.py | 被动抽屉、三种物体、场景参数、任务事件和专家阶段 |
so100_flywheel/mimicgen_drawer.py | 源演示选择、四段参考物变换、插值与重执行 |
so100_flywheel/streams.py、assets.py | 多流采集、时间对齐、质检、资产登记和冻结版本 |
so100_flywheel/learning.py | NPZ 采样、归一化、官方 ACT 配置、训练和动作队列 |
so100_flywheel/drawer_recovery.py | 抓取修正与接触诊断 |
so100_flywheel/sku_act.py | episode 开始时固定选择检查点 |
实验运行于 WSL,核心依赖为 MuJoCo 3.3.7、LeRobot 0.4.0、PyTorch 2.7.1,以及 Menagerie 与 MimicGen 源码。MimicGen 使用提交 72bd767c255545f462e7ccfb2731f2e5d4c1d9bb,上游代码保留原许可证。环境安装入口为 scripts/setup_wsl.sh;完整生成还需要已有的 13 条源演示及其 manifest,仅有训练命令不足以从零还原数据。
已有实验产物时,可以直接查看模型与报告,无须重训。在项目根目录启动静态服务后,打开 /runs/drawer_recovery/sku_policy/dashboard.html,即可查看全部场景结果与代表性对比录像:
# 已配置好依赖的 WSL 环境,当前目录为仿真项目根目录
python -m http.server 8765 --bind 127.0.0.1
# 浏览器访问 http://localhost:8765/runs/drawer_recovery/sku_policy/dashboard.html
以下是已有源数据与依赖时的首轮生成、训练入口,用于说明复现顺序;它们会产生新实验计算,现有归档目录带有防重复覆盖标记:
export PYTHONPATH=.
export MUJOCO_GL=egl

python scripts/drawer_mimicgen.py generate --workers 4
python scripts/audit_mimicgen_drawer.py
python scripts/drawer_mimicgen.py train
python scripts/drawer_mimicgen.py evaluate
补采流程入口为 scripts/drawer_recovery.py,最终固定选择评估为 scripts/evaluate_sku_act.py。复做新实验应使用独立输出位置并重新冻结协议,不能删除防重复标记来覆盖已有证据。完整过程记录在 docs/DRAWER_MIMICGEN_100_REPORT.md 和 docs/DRAWER_RECOVERY_FINAL_REPORT.md;最终规则、指标与重放核验分别在 runs/drawer_recovery/sku_policy/ 下的 protocol.json、comparison.json、audit.json 中。
相关开源实现:MuJoCo、Menagerie SO-100 模型、MimicGen、LeRobot ACT。
9. 这个飞轮下一步该转向哪里
当前最薄弱的部分仍是方块抓取与放入的稳定性,以及杯子难例在策略中的学习效果。下一轮应在新的开发场景上分析失败阶段,验证更可靠的演示,再评估 SKU 均衡采样、动作风格一致性和更短动作执行窗口等改动。最终这 60 个场景保留为受保护评估记录,不能直接把失败位置回灌训练后继续称它们为独立测试。
向真实机器人推进,还需要用视觉和状态估计替代特权环境真值,实测相机与关节同步、坐标标定及接触条件,然后逐项引入受控的物理分布变化。当前的数据 schema、质量报告和版本关联可以复用,但真实采集能力需要另行验证。
这个项目已经打通了从仿真到数据、从数据到策略、从策略失败返回采集的链路。更重要的工程经验是:每一轮都要能回答“哪一类场景改善了,哪一类退步了,用什么证据决定保留哪个模型”。只有把失败诊断、数据来源和独立评估一起保留下来,新增数据才可能持续转化为可靠的能力。

YvYve 陽
Freshman of Artificial Intelligence
I am now a newcomer to AI, so please take care of me and look forward to my growth!